从识别手写数字说起
同样一个“3”,有人写得圆,有人写得扁,有人连笔,有人还会歪一点。我们通常都能认出来。
要让 AI 识别这些不同的写法,应该怎样做?
可以尝试编写规则,描述哪些笔画组合属于“3”。但写法越多,需要考虑的情况也越多。机器学习提供了另一种办法:准备例子和正确答案,让训练程序根据预测结果,逐步调整模型。
听起来像是在“做练习”,但模型究竟改了什么?正确答案又怎样影响它的判断?
从两张小图开始,就能追踪一次完整的变化。
一、图片先变成数值
下面两张黑白教学图分别表示“3”和“8”。每个小格子叫作一个像素,有笔画记为1,没有笔画记为0。
先只取 A、B 两个位置,按“先 A、后 B”记录:
- “3”:A 处没有笔画,B 处有笔画,输入为 [0, 1]。
- “8”:A、B 两处都有笔画,输入为 [1, 1]。
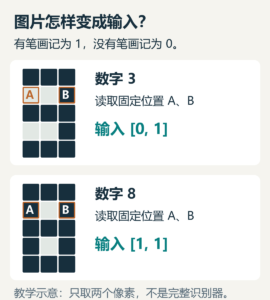
图片上的区别,变成了可以参与计算的数值。
这里刻意只选两张图、两个位置,让每一步都能算清。实际手写识别要处理更多信息和不同写法。A、B 的位置由人选定,后面的训练不会改变它们。
二、先规定怎样读出答案
模型需要回答的是“3”还是“8”。一种简单的设计是:先根据输入算出一个数,再把这个数解释成类别。
我们选0作为分界:
- 大于0,表示判断为“8”。
- 小于0,表示判断为“3”。
- 等于0,落在分界处,本例训练时还要调整。
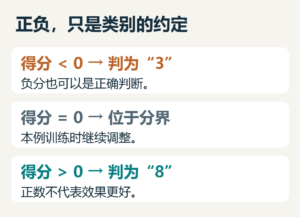
这只是设计时选定的对应关系,没有自然规律规定“正数就是8”。把两个类别交换也可以,但之后的训练规则必须随之调整。
人先确定怎样读结果;模型需要通过训练获得合适的参数,让“8”的图片算到正数一侧,“3”的图片算到负数一侧。
这个用于分类的数,下面称为“得分”。负分并不表示识别效果差,它可以是对“3”的正确判断。
三、用什么办法改变得分?
给 A、B 各配一个可以调整的数值,叫作权重。让输入分别乘上权重,再把两项相加:
得分=A 的输入值×A 的权重+B 的输入值×B 的权重
这套计算和按正负分类的方法,构成了一个简单的感知机模型。两个权重就是它可学习的参数,也按“先 A、后 B”记录。
为了观察训练,让初始权重为 [0, 0]。
现在输入一张“8”,图片对应的输入为 [1, 1]:
得分=1×0+1×0=0。
模型还没有把结果算到“8”所在的正数区域。
训练资料中,这张图片已经配有正确答案“8”,这个答案叫作标签。模型先根据图片计算,训练程序再用标签检查结果;标签并不是作为识别线索一起输入模型的。
正确答案是“8”,当前得分却为0。因此,对这张图片来说,调整目标很明确:提高得分,让它进入正数一侧。
怎样提高?因为这张图的两个输入都是1,计算式就相当于:
得分=A 的权重+B 的权重。
提高其中任何一个权重,都能提高这张图的得分。
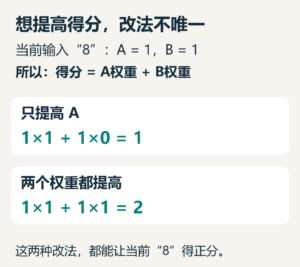
只改 A、只改 B,或者两个一起改,都有可能把这一张图判对。因此,“得分要提高”并不能推出“两个权重必须各加1”。
接下来需要选择一套能够反复执行的训练方法。
四、选定规则,完成第一次更新
本例采用一种简单的感知机学习规则:
判错或得分为0时,根据标签调整权重;已经判对,就保持不变。
需要调整时,怎样选择方向?
- 标签是“8”,希望得分提高,就给各权重加上对应输入值。
- 标签是“3”,希望得分降低,就从各权重减去对应输入值。
这套规则利用了一个计算关系:在当前这张图里,输入为1的位置,权重增加1,得分就增加1;权重减少1,得分就减少1。输入为0的位置,修改权重对当前得分没有作用,因此这次不改它。
每次改多少也是训练设置。本例采用上述幅度,便于计算;也可以把调整幅度按更小的比例缩放。
回到这张“8”。它的输入是[1, 1],两个位置都会影响得分。按照选定规则:
A 的权重:0+1=1
B 的权重:0+1=1
A 这一项从0变成1,B 这一项也从0变成1,总分增加了2:
新得分=1×1+1×1=2。
结果落在正数一侧,按先前约定,模型现在判为“8”。
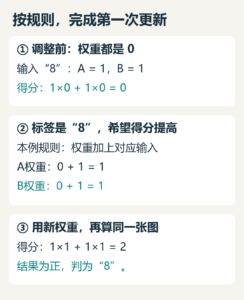
图片没有改变,改变的是模型里的两个权重。相同输入经过新的参数计算,得到了不同结果。
这些步骤可以由程序自动重复执行。人提前准备例子与标签、设定训练方法,不需要逐张图片手动修改权重。
五、改对“8”,会不会影响“3”?
会。所有图片使用的是同一组权重,而不是每张图各有一套。
用刚得到的权重[1, 1]计算“3”。它的输入是[0, 1]:
得分=0×1+1×1=1。
结果仍然为正,模型把“3”也判成了“8”。
现在正确标签是“3”,调整目标变成:降低这张图的得分,让它往负数方向移动。
改哪里才有作用?
A 的输入是0。无论把 A 的权重改成多少,这一项都是0,改变不了当前图片的得分。
B 的输入是1。降低 B 的权重,就能降低得分。
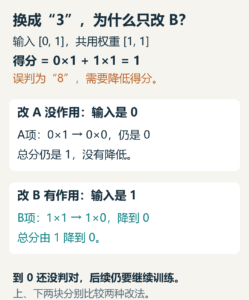
按相同学习规则,分别减去对应输入值:
A 的权重:1-0=1,保持不变。
B 的权重:1-1=0,减少了1。
新权重是[1, 0],“3”的得分从1降到0。方向已经改变,但仍在分界处,后续遇到它还要继续调整。
这解释了为什么不能只看一次更新:它可能改善当前图片的判断,同时影响其他图片。模型需要反复接收不同例子的反馈,调整一套共用参数。
六、反复训练后,权重怎样变化?
继续交替输入“8”和“3”。已经判对,不改权重;判错或得分为0,就按规则更新。
下面记录了实际计算中发生的五次更新。表里省略了没有修改权重的步骤,因此相同标签可能连续出现。
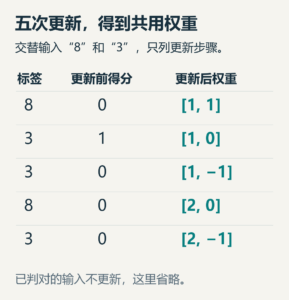
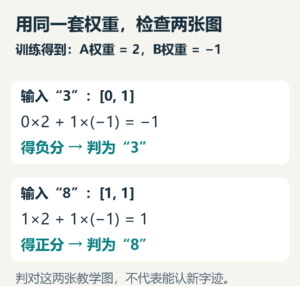
最后得到的权重是 [2, -1]。再把两张图分别代入:
“3”的输入为[0, 1]:
0×2+1×(-1)=-1,判为“3”。
“8”的输入为[1, 1]:
1×2+1×(-1)=1,判为“8”。
两张图都能判对了。
最初,我们没有把“A 的权重为2、B 的权重为-1”写进程序。这两个数是从初始值出发,通过例子、标签和更新规则逐步得到的。
人规定计算结构、怎样解释结果,以及采用什么训练方法;训练过程利用数据的反馈,得到具体参数。换一组数据或训练设置,参数结果可能不同。
这类利用带标签例子训练模型的方法,属于监督学习。感知机是其中一种简单模型,更复杂的模型会使用不同结构和训练方法,不能把这里的加减规则套用到所有 AI 上。
七、判对这两张图,就算学会了吗?
还不能这样判断。
这两张图很简单,甚至可以直接写一条规则区分。把任务缩得这么小,是为了完整展示参数怎样变化,并不代表已经做出了真实的手写识别系统。
真正使用时,要面对新的字迹。需要另外准备没有参与权重调整的图片,检查换一种写法、换一个人书写,模型还能不能认对。
如果训练图片表现很好,新图片却频繁认错,能力就还不足以支持实际使用。对未见过的数据仍能表现良好的能力,叫作泛化,是机器学习的重要目标。
测试条件也要接近实际用途。固定位置的清晰图片,与手机拍下的歪斜、模糊字迹可能相差很大;在前一种条件下表现好,不能保证后一种条件下同样有效。
训练完成后,通常会先固定参数,用模型计算新图片的类别。这个使用已有模型作判断的过程,叫作推理。它与根据标签更新参数的训练过程不同。
回头看,图片提供输入,标签帮助检查预测,训练规则把反馈变成参数调整。更新后的参数保留在模型里,影响它之后的判断。
训练改变参数,推理使用参数,测试检查它对新数据的表现。
机器学习中的“学习”,就在这样具体的变化中发生。最终需要检验的,是这些变化有没有形成对新情况也有用的能力。
